人工知能は、初期には「記号処理」によって論理的に推論するシステムとして始まり、その後、データに応じて内部構造を自律的に調整する「学習モデル」へと進化してきました。
記号処理型AIの時代(1950〜70年代)
人工知能という研究分野が正式に立ち上がったのは、1956年の「ダートマス会議」ですが、1950〜70年代の人工知能研究は「知能とは論理と記号操作で再現できる」という思想に基づいて展開されていました。
当時のコンピュータは処理能力が極めて限られており、大量のデータを直接扱う方式は現実的ではない状況でした。こうした制約の中で、研究者たちは人の思考を論理的な規則の組み合わせとして書き下し、それを機械に実行させることで「人工の知性」を構築しようと試みていたのです。
この時代のAIは、主に次の三つの技術を中心に発展しました。それらはすべて「記号を操作して推論する」という共通の思想に基づいていますが、役割はそれぞれ異なっています。

論理演算
論理演算とは、情報を「IF(条件)〜THEN(結果)」の形式で記述し、その条件が「真」か「偽」かを判定して新しい結論を導き出す仕組みを指します。
📌 あらかじめ「親の親は祖父母である」というルールを設定したうえで、次のような条件を入力として与えます。
・IF「AはBの親である」
・AND「BはCの親である」
この二つの関係がどちらも真と評価されれば、設定されたルールに従って次の結論が同じく真として導かれます。
・THEN「AはCの祖父母である」
逆に、IFまたはANDのいずれかが偽と判定された場合、結論は成立せず、THENは適用されません。
論理演算では、これらの基本的な構造に加えて、条件の選択肢を示すOR、条件を否定するNOTといった演算子も使用されますが、いずれも記号の真偽を組み合わせて結論を導くための操作です。
真偽の判定が明確に定義されていれば、論理演算は誤りなく推論できますが、現実世界のように「どこまでが親か」「例外はどう扱うか」といった曖昧な状況が混在すると処理が破綻します。また、複雑な領域では、真偽判定そのものが事前に定義できない場合も多く、論理だけで知能を表現することの限界が徐々に明らかになっていきました。
探索アルゴリズム
探索アルゴリズムは、論理演算と並んで記号処理型AIを支えていた基本技術です。
論理演算が「与えられた条件から結論を導く仕組み」であるのに対し、探索アルゴリズムは「結論に至るための手順そのものを、候補の中から探し出す仕組み」を担っていました。
記号処理AIの時代には、問題解決を「状態の探索」として捉え、「どの手順を踏めば目的に到達できるかを機械的に列挙し、順番に確かめていく」という方法が多くのシステムで採用されていました。
📌 迷路を解く問題は、探索アルゴリズムの典型例です。
迷路の入口を出発点とし、そこから進める方向を一つずつたどっていきます。分かれ道に来るたびに、まだ試していない道を決められた順序で選び、行き止まりに突き当たれば一つ前の分かれ道に戻って別の道を試します。この「進む・行き止まりなら戻る・別の道を試す」という手順を、出口にたどり着くまで繰り返します。
探索には次のような方法があり、どちらも道をたどる順序の決め方が異なります。
・BFS(幅優先探索):入口に近い場所から順に調べていく方法
・DFS(深さ優先探索):一つの道を行けるところまで進み、行き止まりで戻る方法
どちらの方法も、決められた順序に従って道を一つずつ試し、出口に通じる道を見つけ出します。
しかし、探索アルゴリズムにも明確な限界がありました。分岐のたびに進める道は枝分かれし、一つの道が行き止まりでも、戻ればその先にまた別の枝分かれが広がっています。この入れ子が深くなるほど、調べるべき道は急激に増え、やがて現実的な時間では調べ尽くせないほどに膨れ上がります。さらに、自然言語のように、たどるべき道筋をあらかじめ整理された形で並べられない領域では、探索という枠組み自体が成立しませんでした。
ルールベース推論
ルールベース推論は、記号処理型AIの中心的な技術であり、人間が専門知識を「IF〜THEN」の形式で大量の規則として書き下し、AIがその規則群を参照して結論を導く仕組みです。論理演算が単一の規則に基づいて推論を行うのに対し、ルールベース推論は「多数の規則をどの順番で適用するか」を含めて推論体系を構築する点に特徴があります。
医療診断、装置の故障解析など、専門家が明示的な判断規則を持つ領域で活用されました。
📌 医療診断を例にすると、専門家の判断を次のような形で規則化します。
・IF「発熱がある」AND「咳が続いている」THEN「気道感染の疑い」
・IF「気道感染の疑い」AND「痰の色が濃い」THEN「細菌性の可能性」
・IF「胸部X線に影」THEN「肺炎を疑う」
AIは患者のデータを入力として受け取り、その内容に一致する規則を自動的に適用しながら結論を更新していきます。これらの規則は直列に実行されるわけではなく、それぞれ独立した条件として並列に評価されます。入力された情報に一致するルールがあれば、その都度結論が追加されるだけで、規則同士が階段状に結びついているわけではありません。
ルールベース推論は、論理演算や探索アルゴリズムを組み合わせた仕組みとして発展しました。複数の規則の中から「どれを先に適用すべきか」を探索で判断し、規則の条件に一致するかどうかは論理演算で評価します。つまり、記号処理AIが掲げた「知識を記号として表し、規則を適用すれば知能を再現できる」という思想を最も直接的な形で具現化したのがルールベース推論でした。
しかし、この方式にも構造的な限界がありました。現実の領域では例外や曖昧な症状が多く、すべてを「IF〜THEN」で記述することが不可能になります。規則が増えるほど矛盾や衝突も発生しやすく、どの規則を優先すべきかを人が事前に決めておく必要がありました。また、規則に書かれていないケースに遭遇するとAIは結論を導けず、未知の状況に柔軟に対応することもできません。
ルールベース推論は専門領域で一定の成果を上げましたが、日常的で曖昧な問題には適用できず、「知識をすべて記号化する」という方針そのものの限界が次第に明らかになっていきました。
ニューラルネットワークの停滞と発展
人間の脳の仕組みを参考にした人工ニューロンのモデルは、すでに1943年にマカロックとピッツによって提案されており、「知能を多数の単純な要素の組み合わせとして再現する」という発想そのものは当初から存在していました。しかし、当時のモデルは計算能力や学習手法の制約が大きく、理論的な可能性が示されながらも実用化には至らず、その後の研究の主流は記号処理へと移っていきました。
1980年代以降、記号処理だけでは現実世界の曖昧で例外の多い問題に対応できないことが明らかになるにつれ、「知能を固定した規則で表す」方式の限界が顕在化していきます。この状況の中で、多数の要素が脳のように並列に動作するモデルとして、ニューラルネットワークが再び注目されるようになりました。
研究者たちは、人間の脳が持つ「刺激に応じてつながりの強さが変わる」という特性に着目し、知能を明示的な規則ではなく「データから自律的に形成される構造」として捉え直そうとしました。コンピュータの処理能力は依然として限られていたものの、こうした発想の転換により、ニューラルネットワークは「記号を操作して推論するAI」とは異なる、新しい方向性として再びAI研究の中心に据えられていったのです。
単層パーセプトロン
パーセプトロンは、1958年にフランク・ローゼンブラットによって提案された、脳の神経細胞の働きを模した初期の学習モデルです。このモデルの特徴は、学習によって判断の精度を自動的に向上できる点にあります。
初期のパーセプトロンは単層パーセプトロンと呼ばれ、入力されたデータに、学習によって調整された「重み」という重要度を掛け合わせて合計し、その合計が決められた基準(閾値)を超えるかどうかで、結果を判断します。
パーセプトロンは、数値化されたデータに重みをかけるため、事前に生のデータをどのように数値化するのかを手動で設定します。生のデータのどこに注目し、どのような数値で表すかを人が決めるこの作業を「特徴量設計」といいます。
📌 画像を認識する場合、スキャンした用紙をマス目に分割し、黒は(1)白は(0)というような数値を振り、左上から順に並べる、といった設定を行います。
設定後、左右どちらかに印しのある用紙を読み込ませます。パーセプトロンは、受け取った数値データに重みをかけ、印しが左右どちらにあるか判断します。間違った場合は、正しく判断できる方向へ重みと閾値を少しずつ調整します。
さまざまなパターンの印しが記されている用紙を繰り返し読み込ませ、その都度この調整を行うのが「学習」です。これら学習によって調整される重みや閾値などを総称して「パラメータ」と呼びます。パラメータの主体は重みで、閾値は「バイアス」として加わります。
この学習の仕組みが有望視され、パーセプトロンは注目を集めました。
単層パーセプトロンの出力は、真と偽の二値構造になっており、閾値を境にして真・偽を判断して出力します。そのため、学習する際に読み込んだデータは真の領域と偽の領域に分かれて分布し、その分布は一本の直線で仕分けることができます。これが線形分離です。真と偽を分けるこの直線は、閾値による真偽の区切りにあたります。単層パーセプトロンは、線形分離が可能なデータしか扱えません。
この構造的な問題の解決には、入力層と出力層の間に中間層を加えた多層構造が必要でした。しかし、当時はまだ中間層の学習方法が確立されておらず、線形分離の制限はパーセプトロンの機能的な限界のままでした。その代表例が「XOR(排他的論理和)」と呼ばれる問題です。1969年、記号処理型AIの推進者だったマービン・ミンスキーとシーモア・パパートは著書『Perceptrons』で、単層パーセプトロンがこのXORを解けないことを数学的に証明しました。
📌 XORの判定例
・(0, 0) → 偽
・(0, 1) → 真
・(1, 0) → 真
・(1, 1) → 偽
これを数値化して並べると、真と偽が互い違いに配置され、一本の直線では二つに分けられません。
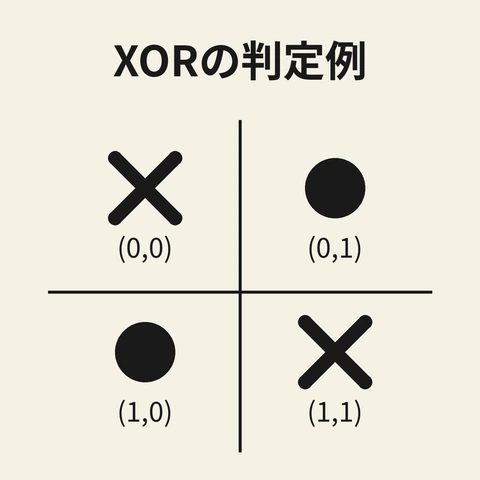
XORは、二つの入力のうちどちらか一方だけが真であれば真、両方が同じであれば偽となる論理です。単層パーセプトロンは一本の直線でしか仕分けできないため、XORを解くことができません。
明確に単層パーセプトロンの限界が示されたことで、加熱していたパーセプトロンへの関心が退き、多層を学習させる方法が見つからないまま、ニューラルネットワークの研究は長い停滞期に入ります。
多層パーセプトロンと誤差逆伝播法
パーセプトロンの課題だった中間層の学習は、1982年にポール・ワーボスが多層パーセプトロンへ適用した、出力から逆向きに誤差を伝えて勾配を求める計算方法によって実現しました。しかし、単層パーセプトロンの発表から20年以上経過し、当時はニューラルネットワークへの関心が低かったため、この成果は当時ほとんど注目されませんでした。
ニューラルネットワークの開発が動き出す契機は、デビッド・ラメルハートらが「誤差逆伝播法(バックプロパゲーション)」として、1986年に発表した論文(ヒントン、ウィリアムズとの共著)でした。ラメルハートらは、誤差逆伝播法が多層の学習に有効であることを示し、ニューラルネットワークの研究は再び関心を集めるようになりました。
単層パーセプトロンは、入力層と出力層がありますが、入力層は数値化されたデータを出力層へ渡し、出力層で計算を行って、閾値を基準として結果を出力します。単層という呼称は、計算を行う層が出力層のみのためで、この層は多数の「ノード(計算を行う最小単位)」によって構成されています。多層化した場合、入力層と出力層の間に中間層が追加されます。この中間層も多数のノードによって構成されており、前の層から受け取ったデータを計算し、結果を次の層に渡していき、最終的に出力層から結果が出力されます。こうして多層パーセプトロンの学習が可能になったことで、単層パーセプトロンでは解けなかったXORも、解けるようになりました。
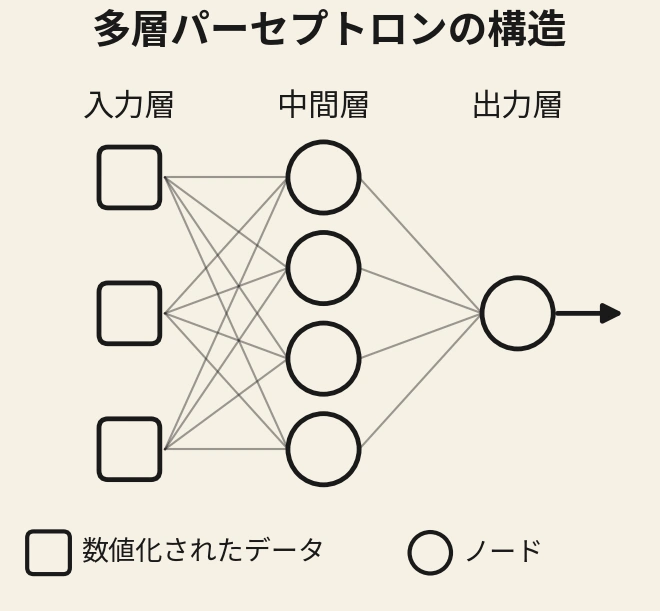
中間層や出力層で行われる計算は、受け取ったデータに対して、重みをかけて合計し、閾値と比べて出力を決定するというものです。そのため、多層パーセプトロンの学習では、出力結果と正答の誤差を、どのパラメータで調整するのかが問題でした。誤差逆伝播法は、出力が正解とどれだけ違っていたか(誤差)を計算し、その誤差を出力側から入力側へ逆向きにたどることで、それぞれのパラメータが誤差にどれだけ影響したかを求める方法です。この影響の度合いは「勾配」と呼ばれます。求めた勾配に従って各パラメータを少しずつ動かし、誤差が小さくなる方向へ調整する手続きが「勾配降下法」です。この学習方法は、多層パーセプトロンにとどまらず、この後に登場するさまざまなニューラルネットワークにも共通して用いられる学習の基本的な仕組みになりました。
時間を扱うモデル:RNNとLSTM
多層パーセプトロンは、特徴量設計によって用意された入力の個数が一定であることを前提にした構造になっています。画像は、サイズをそろえれば画素数が一定になります。一方、文章の場合は、一文ごとに語数が異なり、入力の個数が定まりません。そのため、多層パーセプトロンで文章を扱うには、事前に決まった長さの数値に手動で変換する必要がありました。また、多層パーセプトロンは、入力されたテキストに対して、語句の位置ごとに別の重みで処理するため、「月曜日は雪が降った」と「雪が降ったのは月曜日」では、同じ意味の文章でも、同じとして扱えません。
こうした制限に対処するために開発されたのが、RNN(再帰型ニューラルネットワーク)です。RNNは、多層パーセプトロンのように情報を入力から出力へ一方向に流すのではなく、処理結果を自分自身の入力へ戻す再帰的な接続を持ちます。語を一つずつ順に処理し、前の語を処理した結果(内部状態)を次の語の処理へ引き継ぐことで、語数が一定しない文章を、順序を保ったまま扱えるようにしました。この再帰的な接続によって、RNNは時間方向の依存関係を扱えるようになり、翻訳や音声認識などで役割を広げていきます。
📌 文章の途中で「その後、彼は走り出した」と書かれていた場合、「その後」が何を指しているかは、前に出てきた出来事に依存しています。RNNは、前の入力によって内部状態(数値)が更新され、その数値が次の処理に影響するという仕組みを持っています。
仮に、多層パーセプトロンで「その後」が指している語句を入力に含めても、語句としては捉えられますが、文意として関係づけることができません。
RNNの学習にも誤差逆伝播法が用いられ、時間に沿って各時刻へ誤差をさかのぼらせて勾配を求め、その勾配に従ってパラメータを調整します。しかし、層が深くなったり系列が長くなったりすると、さかのぼる途中で勾配が減衰し、入力層の近くや離れた過去の時刻まで学習信号が届かなくなる勾配消失問題が発生しました。そのためRNNは、離れた語どうしの関係をうまく学習できず、長い文脈を保ったまま処理することに限界がありました。
この限界を補うために登場したのが、1997年に提案された「LSTM(長短期記憶)」です。LSTMは、RNNの内部に「どの情報を残すか」「どの情報を捨てるか」を選び取る仕組み(ゲート機構)を追加した構造を持っています。
📌 LSTMは、重要な情報を「メモに残し」、不要な情報を「その場で忘れる」ような動作を自動的に行います。これにより、文章の冒頭で提示された文脈や特徴を、終わりのほうまで保持しながら処理できるようになりました。
LSTMの導入によって、長文の翻訳、音声の連続認識、チャット文脈の保持など、従来は扱いづらかった問題にも現実的に対応できるようになり、自然言語処理の性能は大きく向上します。
深層学習
2000年代以降、コンピュータの演算能力は大きく伸びました。コンピュータ全体の処理を担うCPUは、一つの部品に複数の処理単位(コア)を載せるマルチコア化や、一つのコアで複数の処理を同時に扱うマルチスレッド化によって、性能を高めていきました。また、米国のエヌビディアは、もともと画像処理を担うGPUの計算能力を、画像処理以外の一般的な計算にも使えるようにする技術「CUDA」を開発し、2007年に公開しました。この技術革新によって、多数の演算を同時に行うGPUの並列処理を、ニューラルネットワークの学習に活用する道が開かれます。
ハードウェアの進化と並行し、この時期には、インターネットの普及と大容量ストレージの低価格化が進みます。そして2000年代末頃から、大量のラベル付き画像を集めたImageNetなど、標準的なデータセットが登場し、大規模なデータを扱える環境も整います。また同時に、多層パーセプトロンで層を深くしたときに学習信号が届かなくなる勾配消失問題も、活性化関数や重みの初期化といった学習手法の進歩により克服されていきました。これにより、手作業で行われていた特徴量設計に頼らず、入力に使う特徴そのものが、誤差逆伝播による重みの調整を通じて、データから直接、取り出されるようになりました。
こうして、層を深く重ねたネットワークを、大規模なデータと十分な処理能力のもとで学習させる「深層学習(ディープラーニング)」が確立しました。学習の仕組み自体は、多層パーセプトロンと同じ誤差逆伝播ですが、より深い層まで学習信号が届くようになり、特徴の抽出までを学習に含められるようになりました。
AttentionとTransformer
RNNやLSTMは、時間に沿って連続するデータを扱う有効な手段でしたが、語を一つずつ順に処理するため、離れた語どうしを結びつけるには、あいだにある語の処理をすべて経由する必要があり、前の語の処理が終わるまで次の語に進めないため、処理を並列に行うことも困難でした。この課題に対して2014年に提案されたのが、「Attention(注意機構)」です。Attentionは、文章中の単語同士がどれくらい関連しているかを数値として計算し、その関連度に応じて情報の重要度を調整する仕組みです。
📌 文章に「生成AIの精度には課題があります」「その問題は解決していません」と続けて書かれている場合、「その」が指す対象は、前の文に登場した語句にあります。
Attentionは、文中のすべての語について、どの語とどれだけ関連するかを統計的な関連度として計算し、最も関連の強い語を参照します。「その」が前文の「課題」と最も強く結びつけば、モデルは次の処理で「その」を「課題」を指すものとして扱います。
当初のAttentionは、RNNに組み込む形で使用され、あいだの処理を経由せずに離れた語を参照できるようになります。しかし、語を順に処理する再帰の構造は残ったままで、計算を並列に行えないという課題は解決しませんでした。
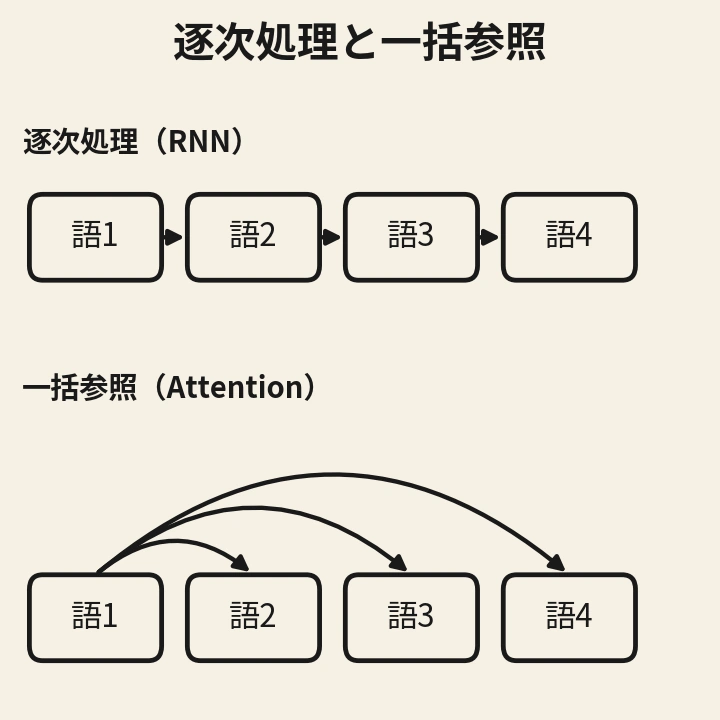
この再帰の構造をなくし、Attentionを全面に据えたものが、2017年に開発された「Transformer」です。語を順に処理する必要がなくなり、文章全体を一括して計算(GPUの行列演算)できるようになりました。層の深さや幅を拡張しても並列化は保たれるため、規模と学習データを大きくするほど性能が伸びる特性を持ち、翻訳、要約、質問応答など多様な自然言語処理で、RNNやLSTMを使用した従来モデルを上回るようになりました。深層学習を自然言語処理で担う構造の主流は、これ以降Transformerになります。
📌 Transformerは、「Self-Attention(自己注意機構)」を複数段重ねることで、入力文の内部にあるさまざまな関連性を段階的に抽出します。単語の位置情報は「位置エンコーディング」という数値表現で補い、順序を失わずに並列処理を行います。
大規模言語モデル
Transformerが持つ、規模を大きくするほど性能が伸びるという特性に沿って、層の数とパラメータ、学習に使うテキストの量を大幅に拡張したものが、大規模言語モデル(LLM)です。呼称にある「大規模」は、この拡張を指しています。
構造
LLMでは、入力されたテキストを「トークン」という最小単位(語や語の一部)に分割し、各トークンは「埋め込み」と呼ばれる複数の数値を並べたものに変換されます。この数値は、各層で、はじめにトークン間の関連性が計算(Attention)され、次にノードによって処理されます。前の層の結果を受けとった層は、同じようにAttentionとノードで計算し、出力結果を次の層に渡します。こうして層を重ねるごとに、文中の関連や特徴が段階的に組み上げられていきます。
学習
LLMの学習では、学習プログラムによって文章の途中までが与えられ、モデルはその次に来るトークンを予測します。その結果が違っていれば、誤差逆伝播法によってパラメータの調整量を計算し、少しずつ修正が行われます。この処理を膨大なテキストで繰り返すことによって、トークンの統計的なパターンが、パラメータの値として反映されます。
📌 学習データに「空が青い」という文があるとします。学習では、「空が」まで見て次のトークンを予測する処理が行われ、実際の続きである「青い」により高い確率を与えるよう、パラメータが修正されます。
しかし学習データには、「空が高い」「空が曇っている」など、「空が」に続く別の文があります。学習は、これらすべてについて予測と修正を繰り返すため、「空が」のあとに「青い」「高い」「曇っている」などがそれぞれどれくらい続きやすいか、という確率の分布が、パラメータの値として反映されていきます。
仮に「青い」と「高い」が同じくらい出てくれば、両方がほぼ同じ確率の候補になります。モデルは、どちらが正しいかを判断しているのではなく、学習データでの続きやすさを、そのまま確率として反映しているのです。
生成
学習を終えたLLMが保持しているのは、辞書のようなデータベースではなく、膨大なパラメータです。パラメータに収められているのは、個々の文や答えではなく、どのトークンのあとにどのトークンが続きやすいか、という統計的なパターンです。
利用者が質問を入力すると、そのテキストがトークンに分割されます。このトークンを起点として、Attentionやノードによって計算され、次に来るトークンが選ばれます。あとは、作文リレーのように、選んだトークンを末尾に加えて、次のトークンを選ぶ、という処理を繰り返し、文章が形づくられていきます。そのため、出力される文章は、意味を組み立てて作られたものではなく、統計的なパターンに従ってトークンを並べた結果が、意味の通ったものになっているのです。
📌 トークンの選択は膨大な計算に支えられています。たとえばGPT-3では、一つのトークンが12,288個の数値の並びとして表され、それが96の層を順に通り抜けます。
一つのトークンを選ぶまでに行われる掛け算や足し算は、およそ3,500億回にのぼり、これが、生成するトークンの数だけ繰り返されます。
更新履歴
関連記事
 生成AIと迎合性
肯定的で共感的な生成AIの応答が、提供する側の調整によって形づくられている構造を分析します。正確さより好ましさを基準とするRLHF、システムプロンプトと安全フィルタ、RAGがそれぞれ何を補正し、何を補…
- 生成AIとハルシネーション
生成AIの出力過程に、内容が正しいかどうかを照合し検証する工程が存在しないという構造を分析します。ハルシネーションが誤動作ではなく通常動作の帰結であること、断定的な語調が内容の確かさと無関係であること…
- 生成AIと認知バイアス
生成AIの普及とともに、その応答に「理解」や「判断」を見出してしまう認知の素地が形づくられてきた過程を分析します。読みやすさ、内容の補完、擬人化、肯定への反応が、能力・善意・誠実さという確かめられてい…
- フィクションが培養したAI像
『禁断の惑星』『2001年宇宙の旅』『ブレードランナー』『ターミネーター』『her』が描いたAI像とともに、現実のAIへの認識が形づくられてきた過程を分析します。信頼できる機械という原形から、自律型A…
- 人の脳と人工ニューラルネットワーク
記憶がビデオカメラのように記録されるという脳への誤解とともに、AIの働きが人と同じものとして受け取られてきた構造を分析します。記憶、思考、理解が神経細胞の組み合わせの再構成として成り立つ仕組みと、パラ…